How AI Image Generation Works (AI က ပုံတွေကို ဘယ်လို ဖန်တီးလဲ)
None of its own. This is a stretch page and is not assessed as part of the machine learning topic. It explains generative AI, one real-world application of machine learning (A4.1.1 covers the types of machine learning and their applications), and connects to A4.2.3, A4.3.2, A4.3.8 and A4.3.9 (all HL) and to the ethics points A4.4.1 and A4.4.2. SL and HL students are both welcome. For assessed image-generation content, see the 2027 Case Study.
မြန်မာလို: ဒီစာမျက်နှာအတွက် သီးသန့် syllabus အပိုင်း မရှိပါဘူး။ ဒါက ထပ်ဆင့် လေ့လာရန် (stretch) စာမျက်နှာ ဖြစ်လို့ machine learning (ဒေတာကနေ သင်ယူတဲ့ စနစ်) ခေါင်းစဉ်ရဲ့ အစိတ်အပိုင်းအဖြစ် စာမေးပွဲမှာ မမေးပါဘူး။ ဒီစာမျက်နှာက generative AI (ပုံ၊ စာ စတဲ့ အကြောင်းအရာ အသစ်တွေကို ထုတ်ပေးတဲ့ AI) ကို ရှင်းပြပါတယ်။ Generative AI က machine learning ရဲ့ လက်တွေ့ အသုံးချပုံ တစ်ခုပါ (A4.1.1 က machine learning အမျိုးအစားတွေနဲ့ သူတို့ရဲ့ အသုံးချပုံတွေကို ဖော်ပြပါတယ်)။ ဒီစာမျက်နှာက A4.2.3, A4.3.2, A4.3.8 နဲ့ A4.3.9 (အားလုံး HL) နဲ့ ethics (ကျင့်ဝတ်) ဆိုင်ရာ အပိုင်း A4.4.1 နဲ့ A4.4.2 တို့နဲ့လည်း ဆက်စပ်ပါတယ်။ ဒီနံပါတ်တွေက IB Computer Science (နိုင်ငံတကာ ကျောင်းတွေမှာ သင်တဲ့ ကွန်ပျူတာသိပ္ပံ သင်ရိုး) ရဲ့ သင်ရိုးထဲက အပိုင်း နံပါတ်တွေပါ။ SL (Standard Level: IB သင်တန်းရဲ့ အခြေခံ အဆင့်) နဲ့ HL (Higher Level: IB သင်တန်းမှာ ပိုနက်နက်ရှိုင်းရှိုင်း လေ့လာရတဲ့ အဆင့်) ကျောင်းသား နှစ်မျိုးလုံး ဖတ်လို့ရပါတယ်။ စာမေးပွဲမှာ မေးတဲ့ ပုံဖန်တီးခြင်း အကြောင်းအရာအတွက် 2027 Case Study (IB က စာမေးပွဲ မတိုင်ခင် ကြိုထုတ်ပေးတဲ့ ခေါင်းစဉ်တစ်ခုအကြောင်း လေ့လာစရာ) ကို ကြည့်ပါ။
ကွန်ပျူတာကို ပုံ အသစ် ထုတ်ပေးနိုင်အောင် လုပ်တဲ့ အယူအဆ သုံးမျိုး ရှိပါတယ်: network (ဒီမှာ neural network ကို ဆိုလိုပါတယ်: အလွှာလိုက် စီထားတဲ့ neuron အတု network) နှစ်ခု အပြိုင်အဆိုင် လုပ်တာ (GANs)၊ အရင် ချုံ့ပြီးမှ အသစ် တီထွင်တာ (variational autoencoders) နဲ့ noise (ပုံပေါ်က ကျပန်း အစက်အပြောက်) ကို ပြန်ဖယ်ဖို့ သင်ယူတာ (diffusion) တို့ပါ။ အပိုင်းတစ်ခုစီက model (ဒေတာကနေ သင်ယူထားတဲ့ program) ကို ဘယ်လို train (ဒေတာနဲ့ လေ့ကျင့်ပေးခြင်း) လုပ်လဲ၊ ပုံ တစ်ပုံကို ဘယ်လို ထုတ်လဲ ရှင်းပြပါတယ်။ ရိုးရိုး ရှင်းလင်းချက်က အရင်လာပါတယ်။ သင်္ချာ ပါတဲ့ အပိုင်းတွေကို အမှတ်အသား ပြထားလို့ အဲဒီ မရောက်ခင် ရပ်လို့ရပါတယ်။ နောက်ပိုင်း အပိုင်းတွေက text prompt (AI ကို ဘာလုပ်ရမလဲ စာနဲ့ ပြောတဲ့ ညွှန်ကြားချက်) တွေ၊ နည်းလမ်းတွေကို ပေါင်းသုံးပုံနဲ့ ethics ဆိုင်ရာ မေးခွန်းတွေ ကို ဖော်ပြပါတယ်။ အတိုချုံး ဖတ်ချင်ရင် နည်းလမ်း တစ်ခုစီရဲ့ ပထမ စာပိုဒ်ကို ဖတ်ပြီး ethics အပိုင်းကို ဖတ်ပါ။ (2022 ကနေ 2026 အထိ ရက်စွဲ ပါတဲ့ အရင်းအမြစ်တွေကို ကိုးကားပြီး 2026 ဇူလိုင်မှာ ရေးထားပါတယ်။ လက်ရှိ စနစ်တွေအကြောင်း ပြောတဲ့ အချက်တွေမှာ ရက်စွဲ ပါပါတယ်။)
မာတိကာ
- ပုံကို ဖတ်တာနဲ့ ပုံကို ဖန်တီးတာက ပြဿနာ မတူပါဘူး
- နည်းလမ်း 1: Network နှစ်ခု အပြိုင်အဆိုင် လုပ်ခြင်း (GANs)
- နည်းလမ်း 2: အရင် ချုံ့ပြီးမှ အသစ် တီထွင်ခြင်း (Autoencoders နဲ့ VAEs)
- နည်းလမ်း 3: Noise ကို ပြန်ဖယ်ဖို့ သင်ယူခြင်း (Diffusion)
- Text Conditioning (စာသားနဲ့ လမ်းညွှန်ခြင်း): ဝါကျ တစ်ကြောင်းက ပုံကို ဘယ်လို လမ်းညွှန်လဲ
- စတုတ္ထ အမျိုးအစား၊ အကြမ်းဖျင်း: Flow-Based Models (ပြန်လှည့်လို့ရတဲ့ အဆင့်တွေနဲ့ ပုံထုတ်တဲ့ model)
- နည်းလမ်းတွေကို ဘယ်လို ပေါင်းသုံးလဲ
- နည်းလမ်း သုံးမျိုးကို နှိုင်းယှဉ်ခြင်း
- Video ကော ဘယ်လိုလဲ
- Ethics (ကျင့်ဝတ်): ဒီပုံကို ဘယ်သူ ဖန်တီးတာလဲ
- ဒီစာမျက်နှာမှာ မပါတဲ့ အကြောင်းအရာများ
- ဆက်စပ်တဲ့ စာမျက်နှာများ
ပုံကို ဖတ်တာနဲ့ ပုံကို ဖန်တီးတာက ပြဿနာ မတူပါဘူး
ထပ်ဆင့် လေ့လာရန်။ A4.3.9 ဖြစ်တဲ့ convolutional neural networks (HL) ပေါ်မှာ အခြေခံပါတယ်။ CNN (ပုံတွေအတွက် deep network) ကို လေ့လာဖူးရင် ကွန်ပျူတာက ပုံကို ဘယ်လို ဖတ်လဲ သိပြီးသားပါ။ ဒီစာမျက်နှာက ဆန့်ကျင်ဘက် ဦးတည်ချက်ကို ပြောတာပါ၊ ဒါပေမဲ့ အဲဒီ နည်းစနစ်ကိုပဲ နောက်ပြန် run တာ မဟုတ်ပါဘူး။
Image classifier (ပုံကို ကြည့်ပြီး အမျိုးအစား ခွဲပေးတဲ့ model) က input (program ထဲ ထည့်ပေးတဲ့ ဒေတာ) ပုံ တစ်ပုံကို label (ပုံက ဘာလဲ ဆိုတဲ့ အမျိုးအစား အမည်) တစ်ခု တပ်ပေးပါတယ်။ Image generator (ပုံ အသစ် ထုတ်ပေးတဲ့ model) ကတော့ pixel (ပုံထဲက အစက် တစ်စက်) တန်ဖိုးတွေကို ထုတ်ပေးပါတယ်။ အများအားဖြင့် random noise ကနေ စပြီး တခါတလေ ရလဒ်ကို လမ်းညွှန်ဖို့ prompt ဒါမှမဟုတ် input ပုံ တစ်ပုံကိုပါ သုံးပါတယ်။
ဖန်တီးတာက တစ်ချက်မှာ ပိုခက်ပါတယ်: ပုံဖန်တီးတဲ့ အလုပ် တစ်ခုမှာ လက်ခံလို့ရတဲ့ output (program က ထုတ်ပြတဲ့ ရလဒ်) အများကြီး ရှိနိုင်လို့ နှိုင်းယှဉ်စရာ အဖြေမှန် တစ်ခုတည်း မရှိပါဘူး။ Machine learning အများစုက တိုင်းတာလို့ရတဲ့ score (အမှတ်) တစ်ခုကို တိုးတက်အောင် လုပ်ပြီး အလုပ်လုပ်တာမို့ တစ်ခုခုကို ဖန်တီးဖို့ ပထမဆုံး လုပ်ရမှာက တိုးတက်အောင် လုပ်လို့ရတဲ့ score တစ်ခုကို ရွေးဖို့ပါ။ ဥပမာ ဖန်တီးထားတဲ့ ပုံတွေကို ပုံ အစစ်တွေနဲ့ ဘယ်လောက် ခွဲခြားနိုင်လဲ၊ ဒါမှမဟုတ် ထည့်ထားတဲ့ noise ကို ဘယ်လောက် ကောင်းကောင်း ခန့်မှန်းနိုင်လဲ ဆိုတာမျိုးပါ။ အောက်က နည်းလမ်း သုံးမျိုးက အဲဒီ မေးခွန်းအတွက် မတူတဲ့ အဖြေ သုံးမျိုးပါ။ “ဘယ် score ကို တိုးတက်အောင် လုပ်နေလဲ” လို့ မေးကြည့်တာက သူတို့ကို ခွဲခြားဖို့ ကောင်းတဲ့ နည်းပါ။
“ဖတ်တဲ့” အပိုင်းကို အရင် ပြန်နွှေးချင်ရင် Training and Evaluating a Model (model ကို train လုပ်ခြင်းနဲ့ အကဲဖြတ်ခြင်း) စာမျက်နှာရဲ့ CNNs အပိုင်းမှာ ရှိပါတယ် (A4.3.9၊ သင်ရိုးထဲမှာ ပါပါတယ်)။
နည်းလမ်း 1: Network နှစ်ခု အပြိုင်အဆိုင် လုပ်ခြင်း (GANs)
ထပ်ဆင့် လေ့လာရန်။ A4.3.2 (binary classification) နဲ့ A4.3.8 (neural networks) တို့နဲ့ ဆက်စပ်ပါတယ်၊ နှစ်ခုလုံး HL ပါ။
Generative adversarial network (GAN၊ အပြိုင်အဆိုင် လုပ်ရင်း ပုံ ဖန်တီးတဲ့ network) ဆိုတာ ဆန့်ကျင်ဘက် အလုပ်တွေ လုပ်တဲ့ network နှစ်ခုကြားက ပြိုင်ပွဲ တစ်ခုပါ။
Generator (ပုံ ထုတ်ပေးတဲ့ network) က ပုံတွေကို ထုတ်ပါတယ်။ အစမှာ train မလုပ်ရသေးလို့ အဓိပ္ပာယ်မရှိတဲ့ အစက်အပြောက်တွေကိုပဲ ထုတ်ပါတယ်။
Discriminator (အစစ်လား အတုလား ခွဲခြားတဲ့ network) ကို ဓာတ်ပုံ အစစ်တွေ (ဥပမာ အိုးထဲမှာ စိုက်ထားတဲ့ အပင် အစစ်တွေရဲ့ ဓာတ်ပုံ ထောင်ချီ) နဲ့ generator ရဲ့ output တွေကို ရောပြီး ပြပါတယ်။ သူက ဘယ်ဟာက ဘာလဲ ခွဲပြောတတ်အောင် သင်ယူပါတယ်။ ဒါက ရိုးရိုး binary classification (input တွေကို အမျိုးအစား နှစ်မျိုး ခွဲခြင်း) ပါပဲ။ ရိုးရိုး နည်းအတိုင်းပဲ train လုပ်ပါတယ်: ဘယ်ပုံတွေက အစစ်၊ ဘယ်ပုံတွေက ဖန်တီးထားတာလဲ ဆိုတာ သိပြီးသားမို့ မှားတဲ့ ဆုံးဖြတ်ချက် တိုင်းကို ပြင်ပေးလို့ရပါတယ်။ အစမှာ discriminator ကလည်း train မလုပ်ရသေးလို့ ခန့်မှန်းပြီးပဲ ဖြေပါတယ်။ Training စဖို့ network နှစ်ခုလုံး တော်နေဖို့ မလိုပါဘူး။
ပုံဖန်တီးခြင်းမှာ မရှိခဲ့တဲ့ score ကို ဒီပြိုင်ပွဲက ပေးပါတယ်:
- Generator ရဲ့ ပုံက discriminator ကို လှည့်စားနိုင်ရင် generator အတွက် အောင်မြင်မှုလို့ သတ်မှတ်ပြီး generator က အဲဒီလို ပုံမျိုး ပိုထုတ်နိုင်အောင် ညှိပါတယ်။
- Discriminator က အတုကို ဖမ်းမိရင် discriminator အတွက် အောင်မြင်မှု၊ generator အတွက် ရှုံးနိမ့်မှု ဖြစ်ပါတယ်။ Generator က အဲဒီလို output မျိုး မထုတ်မိအောင် ညှိပါတယ်။
Network တစ်ခုရဲ့ အမှားတွေက နောက် network တစ်ခုအတွက် training signal (သင်ယူဖို့ အချက်ပြမှု) ဖြစ်လာပါတယ်။ ကျပန်း ခန့်မှန်းတာထက် နည်းနည်းလေးပဲ ပိုကောင်းတဲ့ generator ကလည်း ကျပန်းထက် နည်းနည်းလေးပဲ ပိုကောင်းတဲ့ discriminator ကို တခါတလေ လှည့်စားနိုင်ပါတယ်။ အနိုင် သေးသေးလေး တစ်ခုချင်းက နှစ်ခုလုံးကို ရှေ့ဆက် တွန်းပေးပါတယ်: လှည့်စားရ ပိုခက်လာတဲ့ discriminator က generator ကို ပိုကောင်းလာအောင် တွန်းအားပေးပြီး အဲဒါက တစ်ဖန် discriminator ကို ပိုခက်တဲ့ ဥပမာတွေ ပေးပါတယ်။ Training အဆင်ပြေရင် ဖန်တီးထားတဲ့ အပင်တွေကို discriminator ဖြစ်ဖြစ်၊ လူ ဖြစ်ဖြစ် အစစ်တွေနဲ့ ခွဲခြားရ ခက်လာတဲ့အထိ နှစ်ခုလုံး အတူ တိုးတက်လာပါတယ်။ ဒါပေမဲ့ training က မှားယွင်းသွားနိုင်ပါသေးတယ်: အောက်မှာ ဖော်ပြထားသလို converge (training က တည်ငြိမ်တဲ့ အခြေအနေ တစ်ခုကို ရောက်သွားခြင်း) မဖြစ်တာမျိုး ဖြစ်နိုင်ပါတယ်။
Network နှစ်ခု အတူ တိုးတက်လာပါတယ်။ Generator ကို ကူးယူဖို့ label တပ်ထားတဲ့ ပုံကောင်း ဥပမာတွေ မပေးပါဘူး: သူ့ပုံတွေ အစစ်လို့ ထင်ရလား မရလား ဆိုတဲ့ discriminator ရဲ့ feedback (ပြန်လည် အကြံပြုချက်) ကနေပဲ သင်ယူပါတယ်။
ပုံထဲက စာတွေရဲ့ အဓိပ္ပာယ်: generator (invents images: ပုံတွေ တီထွင်ထုတ်တယ်)၊ its image (သူထုတ်တဲ့ ပုံ)၊ real photographs (ဓာတ်ပုံ အစစ်များ)၊ discriminator (an ordinary classifier: ရိုးရိုး classifier တစ်ခု)၊ “real or fake?” (အစစ်လား အတုလား)။ အောက်က မြှားကွေးနားက စာက ဆုံးဖြတ်ချက် တိုင်းက နှစ်ခုလုံးကို train လုပ်ပေးတယ်၊ fooled (လှည့်စားခံရ) ဆိုရင် generator ကို အားဖြည့်ပြီး caught (ဖမ်းမိ) ဆိုရင် discriminator ကို အားဖြည့်တယ် လို့ ဆိုလိုပါတယ်။ Training over time (အချိန်ကြာလာတာနဲ့အမျှ training) အောက်က ပုံ သုံးပုံမှာ speckle (အစက်အပြောက်)၊ roughly a plant (အပင်နဲ့ အကြမ်းဖျင်း တူတာ)၊ convincing (အစစ်လို ထင်ရတာ) နဲ့ judge: guessing / sharpening / cannot tell (ဆုံးဖြတ်သူ: ခန့်မှန်းနေဆဲ / ထက်မြက်လာ / ခွဲမခြားနိုင်တော့) လို့ ရေးထားပါတယ်။
ကိုယ်တိုင် စမ်းကြည့်ပါ: အလွယ်ဆုံး နိုင်နည်းက ဘာလဲ။ Generator ရဲ့ တစ်ခုတည်းသော ရည်မှန်းချက်က discriminator ကို လှည့်စားဖို့ပဲ ဆိုရင် သူ ကျရောက်သွားနိုင်တဲ့ အရိုးရှင်းဆုံး နည်းဗျူဟာက ဘာဖြစ်မလဲ။ အဖြေ မဖွင့်ခင် စဉ်းစားကြည့်ပါ။
ဒါက ဘယ်လို ချို့ယွင်းချက်ကို ဖြစ်စေလဲ ကြည့်ရန်
Discriminator ကို အမြဲလိုလို လှည့်စားနိုင်တဲ့ ပုံ တစ်ပုံ ဒါမှမဟုတ် ပုံ အမျိုးအစား နည်းနည်းကို ရှာပြီး အဲဒါကိုပဲ ထပ်ခါထပ်ခါ ထုတ်တာပါ။ ဒီ ချို့ယွင်းချက်ကို mode collapse (output တွေ တစ်မျိုးတည်းလို ဆင်တူသွားခြင်း) လို့ ခေါ်ပါတယ်: output တွေက training data (model သင်ယူဖို့ ပေးတဲ့ ဒေတာ) ထဲက စုံလင်မှု တစ်ခုလုံးကို ဖြန့်ပြီး မဖုံးဘဲ အပိုင်း သေးသေးလေး တစ်ခုကိုပဲ ဖုံးပါတယ်။ ဒီ ချို့ယွင်းချက်က bug (code ထဲက အမှား) ကနေ လာတာ မဟုတ်ဘဲ ဆုချတဲ့ ပုံစံ ကိုယ်တိုင်ကနေ လာတာပါ: discriminator ကို လှည့်စားနိုင်ရင် generator ဆုရပါတယ်၊ စုံလင်အောင် ထုတ်လို့ ဆုရတာ မဟုတ်ပါဘူး။ ဆက်မေးခွန်း: တူညီတဲ့ output ကို ထပ်ခါထပ်ခါ ထုတ်တာ အကျိုးမရှိတော့အောင် training မှာ ဘာကို ပြောင်းမလဲ။
ပုံထဲက စာတွေရဲ့ အဓိပ္ပာယ်: healthy: outputs spread out (ကောင်းမွန်တဲ့ training: output တွေ ပြန့်နေတယ်)၊ mode collapse: one trick, repeated (နည်း တစ်ခုတည်းကို ထပ်ခါထပ်ခါ သုံးတယ်)၊ everything the generator makes looks alike (generator ထုတ်သမျှ အားလုံး ဆင်တူနေတယ်)။
Adversarial training (network နှစ်ခုကို အပြိုင်အဆိုင် train လုပ်ခြင်း) မှားယွင်းသွားတဲ့အခါ။ Mode collapse မှာ ဘာမှ ပျက်စီးနေတာ မရှိပါဘူး: generator က သူ့ကို ပေးထားတဲ့ ရည်မှန်းချက်ကို အကောင်းဆုံး ဖြစ်အောင် လုပ်နေတာပါ၊ ဒါပေမဲ့ အဲဒီ ရည်မှန်းချက်က လူတွေ တကယ် လိုချင်တာနဲ့ အတိအကျ မကိုက်ပါဘူး။ Reinforcement learning (ဆုနဲ့ ဒဏ်ကနေ သင်ယူခြင်း) မှာ reward (ဆု) ကို မှားရွေးထားရင်လည်း ဒီလို ပြဿနာမျိုး ဖြစ်ပါတယ်။ နောက်ထပ် ချို့ယွင်းချက် နှစ်ခုလည်း အရေးကြီးပါတယ်၊ ဘာလို့လဲဆိုတော့ training တည်ငြိမ်မှုက ဒီနည်းလမ်းကို အကဲဖြတ်ရာမှာ ပါဝင်လို့ပါ:
- Converge မဖြစ်ခြင်း။ Network တစ်ခုစီက နောက်တစ်ခုရဲ့ နောက်ဆုံး ပြောင်းလဲမှုတွေကို အမြဲ တုံ့ပြန်နေတာမို့ training က တည်ငြိမ်သွားမယ့်အစား အတက်အကျ လွှဲနေနိုင်ပါတယ်။ Discriminator က အမြဲ ပြောင်းလဲနေတာမို့ supervised training (label တပ်ထားတဲ့ ဥပမာတွေနဲ့ train လုပ်ခြင်း) မှာ loss curve (train လုပ်ရင်း အမှား ပမာဏ ပြောင်းလဲပုံကို ပြတဲ့ ဂရပ်) တဖြည်းဖြည်း ကျသွားသလို ကျသွားတဲ့ score တစ်ခုတည်း မရှိပါဘူး။ ဒါကြောင့် loss တန်ဖိုးတွေကို ပုံရဲ့ အရည်အသွေး တိုင်းတာချက်အဖြစ် ဖတ်ရ ပိုခက်ပါတယ်။
- တစ်ဖက်က တစ်ဖက်ကို အနိုင်ယူသွားခြင်း။ အရမ်း မြန်မြန် အရမ်း တော်သွားတဲ့ discriminator က အရာအားလုံးကို လုံးဝ ယုံကြည်ချက်နဲ့ ငြင်းပယ်ပါတယ်။ Generator ရတဲ့ feedback က ဘယ်ဘက်ကို သွားရင် အမှား နည်းမလဲ ဆိုတဲ့ အရိပ်အမြွက် မပါဘဲ “မှားတယ်” ဆိုတာ တစ်ခုတည်း ဖြစ်သွားပြီး generator က ဆက် မတိုးတက်တော့ပါဘူး။
ဖြစ်နိုင်တဲ့ ပြင်ဆင်ချက်တွေထဲမှာ network နှစ်ခုရဲ့ learning rate (တစ်ကြိမ်မှာ ဘယ်လောက် ညှိမလဲ သတ်မှတ်တဲ့ တန်ဖိုး) တွေကို တစ်ခုနဲ့တစ်ခု အချိုးချင်း ပြောင်းတာ၊ discriminator သင်ယူတဲ့ မြန်နှုန်းကို ကန့်သတ်တာနဲ့ generator ကို အသုံးဝင်တဲ့ gradient (ဘယ်ဘက်ကို ညှိရင် အမှား လျော့မလဲ ပြတဲ့ ဦးတည်ချက်) တွေ ပေးနိုင်တဲ့ loss function (model ရဲ့ အမှား ပမာဏကို တွက်တဲ့ function) ကို ရွေးတာ ပါပါတယ်။ ဒီ ချိန်ခွင်လျှာကို ထိန်းရတာက adversarial training ရဲ့ အခက်အခဲ တစ်ခုဖြစ်ပြီး အောက်က တခြား နည်းလမ်းတွေကို စဉ်းစားရတဲ့ အကြောင်းရင်း တစ်ခုလည်း ဖြစ်ပါတယ်။
စာမေးပွဲမှာ မေးတဲ့ GANs အကြောင်းအတွက် 2027 Case Study ကို ကြည့်ပါ။
နည်းလမ်း 2: အရင် ချုံ့ပြီးမှ အသစ် တီထွင်ခြင်း (Autoencoders နဲ့ VAEs)
ထပ်ဆင့် လေ့လာရန်။ A4.2.3 (HL) ဖြစ်တဲ့ dimensionality reduction (အရေးကြီးတာ မပျောက်ဘဲ feature အရေအတွက် လျှော့ခြင်း) နဲ့ ဆက်စပ်ပါတယ်: autoencoder (ဒေတာကို ချုံ့ပြီး ပြန်ဖော်ဖို့ သင်ယူတဲ့ network) က input ကို ပြန်တည်ဆောက်နိုင်မယ့် ကျစ်လျစ်တဲ့ ဖော်ပြပုံ (compact representation) တစ်ခုကို သင်ယူပါတယ်။
သီအိုရီ မစခင် ပဟေဠိ တစ်ခုနဲ့ စကြရအောင်။
အရင် ကိုယ်တိုင် စမ်းကြည့်ပါ: ဂဏန်း သုံးလုံးကို တစ်လုံးတည်း ဖြစ်အောင် ချုံ့ပါ။ ဒီမှာ ဂဏန်း သုံးလုံးစီပါတဲ့ အတန်း လေးတန်း ရှိပါတယ်:
2,  4,   8
3,  9,  27
4, 16,  64
5, 25, 125
အတန်း တစ်တန်းစီကို ဂဏန်း တစ်လုံးတည်း နဲ့ အစားထိုးပါ။ သင့်ဂဏန်းကိုပဲ မြင်ရတဲ့ လူက မူလ ဂဏန်း သုံးလုံးလုံးကို ပြန်တည်ဆောက်နိုင်အောင် ရွေးပါ။ အဖြေ မဖွင့်ခင် စည်းမျဉ်းကို ရှာကြည့်ပါ။
စည်းမျဉ်းနဲ့ ဘာကြောင့် အရေးကြီးလဲ ကြည့်ရန်
အတန်း တစ်တန်းစီက ဂဏန်း တစ်လုံး၊ သူ့ရဲ့ နှစ်ထပ်ကိန်း (square) နဲ့ သုံးထပ်ကိန်း (cube) ပါ။ ဒါကြောင့် အတန်းတွေကို 2, 3, 4 နဲ့ 5 အဖြစ် ချုံ့နိုင်ပြီး “3” ကို ကိုင်ထားတဲ့ ဘယ်သူမဆို “3, 9, 27” ကို ပြန်တည်ဆောက်နိုင်ပါတယ်။
ဒီ လေ့ကျင့်ခန်းက compression (ဒေတာ ချုံ့ခြင်း) ရဲ့ လက္ခဏာ လေးခုကို ပြပါတယ်:
- တန်ဖိုး သုံးခုက တစ်ခု ဖြစ်သွားပြီး ဘာမှ မဆုံးရှုံးပါဘူး။
- ချုံ့နည်းကို ရှာဖို့ အတန်း လေးတန်းလုံးမှာ တူညီတဲ့ pattern (ပုံစံ) ကို ရှာရပါတယ်: ဒေတာကို ကောင်းကောင်း ချုံ့နိုင်ဖို့ ဒေတာကို နားလည်ဖို့ လိုပါတယ်။
- စည်းမျဉ်းကို ဥပမာတွေကနေ ကောက်ချက်ချခဲ့ပါတယ်။ Autoencoder ကလည်း ဥပမာတွေကနေ သင်ယူပါတယ်၊ ဒါပေမဲ့ သူက ကိန်းဂဏန်း parameter (model ထဲက ညှိလို့ရတဲ့ ကိန်းဂဏန်း တန်ဖိုး) တွေကို ညှိပြီး သင်ယူတာပါ။
- တကယ့် ဒေတာက pattern တစ်ခုနဲ့ အကြမ်းဖျင်းပဲ ကိုက်နိုင်လို့ ချုံ့တဲ့အခါ အချက်အလက် တချို့ ဆုံးရှုံးနိုင်ပါတယ်။ တကယ့် စနစ်က မူရင်းကို အတိအကျ မိတ္တူ ပြန်မထုတ်ဘဲ မူရင်းနဲ့ နီးစပ်တာကို ပြန်တည်ဆောက်ပါတယ်၊ ဒါတောင် အသုံးဝင်ပါသေးတယ်။
ထပ်ဆောင်း မေးခွန်း: အဲဒီ စည်းမျဉ်းနဲ့ပဲ 4, 10, 19 လို ပဉ္စမ အတန်းကို ကိုယ်စားပြုနိုင်မလား။ ဘယ် အချက်အလက်တွေ ဆုံးရှုံးမလဲ ရှင်းပြပါ။
Autoencoder မှာ အလယ်မှာ ဆက်ထားတဲ့ အပိုင်း နှစ်ပိုင်း ရှိပါတယ်။ Encoder (input ကို ချုံ့ပေးတဲ့ အပိုင်း) က input (pixel တန်ဖိုး ထောင်ချီ ဖြစ်နိုင်ပါတယ်) ကို ယူပြီး code (ဒီနေရာမှာ program code မဟုတ်ပါ) လို့ ခေါ်တဲ့ ဂဏန်း စာရင်း တိုတို တစ်ခုအဖြစ် ချုံ့ပါတယ်။ Decoder (code ကနေ မူရင်းကို ပြန်ဖော်တဲ့ အပိုင်း) က code ကိုပဲ ယူပြီး မူရင်းကို ပြန်တည်ဆောက်ဖို့ ကြိုးစားပါတယ်။ Training က reconstruction error (ပြန်တည်ဆောက်ထားတာနဲ့ မူရင်းကြား ကွာခြားချက်) လျော့အောင် အပိုင်း နှစ်ပိုင်းလုံးကို ညှိပါတယ်။ ဒါက အပေါ်က ပဟေဠိနဲ့ အလုပ်ချင်း အတူတူပါပဲ: ကျဉ်းမြောင်းတဲ့ အလယ်ပိုင်း (bottleneck) ကို ဖြတ်ပြီးနောက် ဝင်လာတာကို ပြန်တည်ဆောက်ရတာပါ။
ကျယ်၊ ကျဉ်း၊ ကျယ်: encoder က input ကို code အဖြစ် ချုံ့ပြီး decoder က အဲဒီ code ကနေ ပြန်တည်ဆောက်ပါတယ်။ ဖြစ်နိုင်တဲ့ code အားလုံးရဲ့ အစုကို latent space လို့ ခေါ်ပါတယ် (“latent” ဆိုတာ ဖုံးကွယ်နေတဲ့ လို့ အဓိပ္ပာယ်ရပါတယ်: ပုံထဲမှာ မြင်ရတဲ့ အရာ မဟုတ်ဘဲ အလယ်က ဖော်ပြပုံ ဖြစ်ပါတယ်)။ ထည့်လိုက်တာကိုပဲ ပြန်ထုတ်ဖို့ network တစ်ခုကို ဘာလို့ train လုပ်ရတာလဲ။ ပုံ တစ်ပုံကို ချုံ့ပြီး ပြန်တည်ဆောက်နိုင်ဖို့ network က ဒေတာထဲက pattern တွေကို ရှာရပါတယ်၊ ဒါကြောင့် code ထဲမှာ အဓိပ္ပာယ်ရှိတဲ့ အချက်အလက်တွေ ပါလာပါတယ်။
ပုံထဲက စာတွေရဲ့ အဓိပ္ပာယ်: input၊ encoder (squeeze: ညှစ်ချုံ့)၊ the code (code)၊ only what is needed to rebuild the input (input ကို ပြန်တည်ဆောက်ဖို့ လိုတာပဲ)၊ decoder (rebuild: ပြန်တည်ဆောက်)၊ output။
ရိုးရိုး autoencoder က generator မဟုတ်ဘဲ ချုံ့ပေးတဲ့ စနစ် (compressor) တစ်ခုပါ: သူ့ကို ပေးတဲ့ input တွေကို ပြန်တည်ဆောက်ဖို့ train လုပ်ထားတာပါ။ Variational autoencoder (VAE၊ ပုံ အသစ် ထုတ်နိုင်အောင် ပြင်ထားတဲ့ autoencoder) က generator ဖြစ်လာစေမယ့် ပြောင်းလဲမှု တစ်ခု ထပ်ထည့်ပါတယ်: code တွေ latent space ထဲမှာ ဘယ်လို ပြန့်နေလဲ ဆိုတာကိုပါ သင်ယူပြီး ကန့်သတ်ထားတာမို့ တကယ့် input တွေရဲ့ code တွေ ဘယ်နေရာမှာ ကျလေ့ရှိလဲ သိပါတယ်။ Train ပြီးတဲ့အခါ encoder ကို ဘေးဖယ်ထားလို့ ရပါတယ်။ အဲဒီ နေရာထဲကနေ point (အမှတ်) တစ်ခုကို ကျပန်း ရွေးပြီး decoder ကို ဖြတ်လိုက်ရင် training data ရဲ့ ပုံစံမျိုးနဲ့ ဖန်တီးထားတဲ့ ပုံ တစ်ပုံ ထွက်လာပါတယ်။
Latent space ထဲကနေ code တစ်ခုကို sample (ကျပန်း ရွေးယူ) လုပ်ပြီး decode (မူရင်းအဖြစ် ပြန်ဖော်) လုပ်တာက compressor ကို generator အဖြစ် ပြောင်းပေးတဲ့ အဆင့်ပါ။
ပုံထဲက စာတွေရဲ့ အဓိပ္ပာယ်: encoder၊ not needed any more (မလိုတော့ဘူး)၊ where real codes land (တကယ့် code တွေ ကျတဲ့ နေရာ)၊ pick one at random (တစ်ခုကို ကျပန်း ရွေး)၊ decoder၊ something new (အသစ် တစ်ခု)။
နည်းလမ်း 3: Noise ကို ပြန်ဖယ်ဖို့ သင်ယူခြင်း (Diffusion)
ထပ်ဆင့် လေ့လာရန်။ A4.1.1 ဖြစ်တဲ့ machine learning ရဲ့ အသုံးချပုံတွေနဲ့ ဆက်စပ်ပါတယ်: 2026 ခုနှစ် အခြေအနေအရ လူသုံးများတဲ့ ပုံဖန်တီးတဲ့ tool အများအပြားရဲ့ နောက်ကွယ်မှာ diffusion (noise ကို တစ်ဆင့်ချင်း ဖယ်ရင်း ပုံ ဖန်တီးတဲ့ နည်း) ရှိပါတယ်။
Diffusion က မညီမျှမှု တစ်ခုပေါ်မှာ အခြေခံပါတယ်: ပုံ တစ်ပုံကို ဖျက်ဆီးရတာ လွယ်ပြီး ဖန်တီးရတာ ခက်ပါတယ်။ Diffusion model တွေက လွယ်တဲ့ ဦးတည်ချက်ကို ပြောင်းပြန် လုပ်တတ်အောင် သင်ယူပါတယ်။
ပုံကို ဖျက်ဆီးဖို့ ကျွမ်းကျင်မှု မလိုပါဘူး။ Pixel တိုင်းရဲ့ အနီ၊ အစိမ်း၊ အပြာ တန်ဖိုးတွေကို ကျပန်း ပမာဏ နည်းနည်းစီ ပြောင်းပါ (ဒီနေရာမှာ noise ဆိုတာ အဲဒီ ကျပန်း အစက်အပြောက်တွေကို ဆိုလိုတာပါ)၊ ပြီးရင် ထပ်လုပ်ပါ။ အဆင့် လုံလောက်အောင် လုပ်ပြီးရင် ဘယ် ဓာတ်ပုံမဆို တီဗီ လိုင်းမမိတဲ့အခါ မြင်ရတဲ့ အစက်အပြောက်တွေ (static) လို ဖြစ်သွားပါတယ်။
လှည့်ကွက်က network တစ်ခုကို လွယ်တဲ့ ဦးတည်ချက်အတိုင်း နောက်ပြန် run တတ်အောင် တစ်ကြိမ်မှာ အဆင့် သေးသေးလေး တစ်ဆင့်စီ train လုပ်တာပါ:
- Training (train လုပ်ခြင်း)။ ဓာတ်ပုံ အစစ် တစ်ပုံ ယူပါ။ Noise နည်းနည်း ထည့်ပြီး မထည့်ခင်နဲ့ ထည့်ပြီးနောက် ပုံ အတွဲကို သိမ်းထားပါ။ နောက်ထပ် နည်းနည်း ထပ်ထည့်ပြီး အဲဒီ အတွဲကိုလည်း သိမ်းပါ။ ပုံက အစက်အပြောက် သက်သက် ဖြစ်သွားတဲ့အထိ ထပ်လုပ်ပါ။ ဘေးချင်းကပ် အတွဲ တိုင်းက training ဥပမာ တစ်ခုပါ: “ပျက်စီးမှု တစ်ဆင့်က ဒီလို ပုံစံ ရှိတယ်၊ အဲဒါကို ပြန်ပြင်တတ်အောင် သင်ယူပါ။”
- Generating (ပုံ ထုတ်ခြင်း)။ ထုတ်ဖို့ ဘာမှ မကုန်ကျတဲ့ ကျပန်း အစက်အပြောက် သက်သက်ကနေ စပါ။ Train ပြီးသား တစ်ဆင့်ပြန်ပြင်တဲ့ network ကို သုံးပါ။ ပုံ တစ်ပုံ ပေါ်လာတဲ့အထိ ထပ်ခါ ထပ်ခါ သုံးပါ။
ခုန်ကြီး တစ်ခါတည်း မခုန်ဘဲ အဆင့်သေး အများကြီး ဘာလို့ သုံးတာလဲ။ Noise တစ်ဆင့်သေးကို ပြန်ဖယ်တာက သင်ယူလို့ရတဲ့ အလုပ်ပါ၊ ဘာလို့လဲဆိုတော့ အဲဒီ အဆင့် မတိုင်ခင်က ပုံကို အများစု မြင်နေရသေးလို့ပါ။ အစက်အပြောက် သက်သက်ကနေ ဓာတ်ပုံ တစ်ပုံကို တစ်ခါတည်း ခုန်ကူးရင် network မှာ အခြေခံစရာ ဘာမှ မရှိသလောက်ပါပဲ။ ဒါကြောင့် training မှာ noise ပမာဏ အမျိုးမျိုးရှိတဲ့ ဥပမာတွေကို သုံးပါတယ်။ ဒါမှ network က နည်းနည်း ပျက်နေတဲ့ ပုံတွေရော၊ အများကြီး ပျက်နေတဲ့ ပုံတွေကိုပါ denoise (noise ဖယ်ရှားခြင်း) လုပ်တတ်လာပြီး ပုံထုတ်တဲ့အခါ ပုံ တစ်ပုံ ဖြစ်လာတဲ့အထိ denoise အဆင့်သေးကို ထပ်ခါထပ်ခါ လုပ်ပါတယ်။
Noise လှေကား။ ညာဘက်ကို သွားတဲ့ အဆင့်တိုင်းက အသေးအဖွဲ ပျက်စီးမှုပါ။ Train ထားတဲ့ network က ဘယ်ဘက်ကို သွားတဲ့ အဆင့်သေးကိုပဲ သင်ယူပြီး ပုံထုတ်တာက အစက်အပြောက် သက်သက်ကနေ စပြီး အဲဒီ အဆင့်ကို ထပ်ခါထပ်ခါ လုပ်တာပါ။
ပုံထဲက စာတွေရဲ့ အဓိပ္ပာယ်: အပေါ်ဆုံးက adding noise: easy, just nudge every pixel, repeat → (noise ထည့်တာ: လွယ်တယ်၊ pixel တိုင်းကို နည်းနည်းစီ ပြောင်းပြီး ထပ်လုပ်ရုံပဲ →)၊ one adjacent pair = one training example (ဘေးချင်းကပ် အတွဲ တစ်တွဲ = training ဥပမာ တစ်ခု)၊ ← removing it, one step at a time: this is the direction we train (← noise ကို တစ်ဆင့်ချင်း ဖယ်တာ: ဒါက train လုပ်တဲ့ ဦးတည်ချက်)၊ အောက်ဆုံးက Run the bottom row alone, right to left, starting from pure static: that is generation. (အောက်တန်းကိုပဲ အစက်အပြောက် သက်သက်ကနေ စပြီး ညာကနေ ဘယ်ကို run ရင် ဒါက ပုံထုတ်ခြင်း ဖြစ်ပါတယ်။)
အမေးများတဲ့ မေးခွန်း နှစ်ခု:
- “ဒါဆို မူရင်း ဓာတ်ပုံကို ပြန်ရလာတာလား။” မဟုတ်ပါဘူး။ ပုံထုတ်တာက training ဓာတ်ပုံ တစ်ပုံကို noise ထည့်ထားတဲ့ ပုံကနေ စတာ မဟုတ်ဘဲ အသစ် sample လုပ်ထားတဲ့ အစက်အပြောက်ကနေ စတာပါ။ Network က သူသင်ယူထားတဲ့ pattern တွေကို သုံးပြီး အစစ်လို ထင်ရတဲ့ (plausible) ပုံ တစ်ပုံကို ထုတ်ပါတယ်။ ဒါပေမဲ့ ဒါက output တိုင်း ကိုယ်ပိုင် အသစ် ဖြစ်တယ်လို့ မဆိုလိုပါဘူး: diffusion model တွေက training ပုံ တချို့ကို အလွတ်မှတ်မိပြီး အတော်လေး တူအောင် ပြန်ထုတ်နိုင်ပါတယ်၊ Carlini et al. (2023) ကို ကြည့်ပါ။ အစစ်လို ထင်ရတဲ့ ပုံနဲ့ ကူးယူထားတဲ့ ပုံကြား ကွာခြားချက်က ethics အပိုင်းမှာ ထပ်ပြီး အရေးပါလာပါတယ်။
- “Noise ဆိုတာ ဘယ်လို ကျပန်းမှုမဆို ဖြစ်လို့ရလား။” ကျပန်းပါပဲ၊ ဒါပေမဲ့ စိတ်ကြိုက် မဟုတ်ပါဘူး။ ပြောင်းလဲမှုတွေက သတ်မှတ်ထားတဲ့ ဖြန့်ဝေပုံ (spread) တစ်ခုကို လိုက်ပါတယ် (အပြောင်းအလဲ သေးသေးလေးတွေ ဖြစ်ဖို့ များပြီး ကြီးကြီးတွေ ဖြစ်ဖို့ ရှားပါတယ်)၊ ပြန်ဖယ်တဲ့ အဆင့်ကိုလည်း အဲဒီ ဖြန့်ဝေပုံ အတိအကျအတွက် train လုပ်ထားပါတယ်။
ကိုယ်တိုင် စမ်းကြည့်ပါ: စက္ကူပေါ်မှာ noise ထည့်ကြည့်ပါ။ 4 × 4 ဇယားကွက် တစ်ခု ဆွဲပါ။ အပေါ် နှစ်တန်းကို အရောင် တစ်မျိုး၊ အောက် နှစ်တန်းကို နောက်အရောင် တစ်မျိုး ခြယ်ပါ။ အကွက် တစ်ကွက်စီရဲ့ အရောင်ကို ကျပန်း နည်းနည်းစီ ပြောင်းပြီး ပြန်ဆွဲပါ။ မူလ ပုံစံကို သူငယ်ချင်း တစ်ယောက်ကို ခန့်မှန်းခိုင်းပါ: တစ်ဆင့်ပြီးရင် ဒါက အများအားဖြင့် လွယ်ပါတယ်။ အပြောင်းအလဲတွေကို 20 ကြိမ် ထပ်လုပ်ပြီး ထပ်မေးပါ: အဲဒီအချိန်မှာ ပုံစံက နည်းနည်းလေးပဲ ကျန်ပါတော့တယ်။ အဲဒီ ကွာခြားချက်ကြောင့် diffusion model က noise ပမာဏ မတူတဲ့ ဥပမာ အများကြီးကနေ noise ကို အဆင့်သေးတွေနဲ့ ပြန်ဖယ်ဖို့ သင်ယူတာပါ။ (ပိုကြီးတဲ့ ပုံစံ: ကိုယ့် ဓာတ်ပုံ တစ်ပုံကို ယူပြီး photo editor (ဓာတ်ပုံ ပြင်တဲ့ software) နဲ့ noise ကို တဖြည်းဖြည်း ပိုထည့်ထားတဲ့ မိတ္တူ 5 ခု သိမ်းပါ၊ ပြီးရင် အဲဒီ အစဉ်ကို ပြောင်းပြန် ကြည့်ပါ။ ပြောင်းပြန် အစဉ်က diffusion model ပုံထုတ်တဲ့အခါ လုပ်တာနဲ့ ဆင်တူပါတယ်။)
နောက်ဆုံးမှာ စာသား ဝင်လာပါတယ်။ Training ဓာတ်ပုံ တိုင်းမှာ စာနဲ့ ရေးထားတဲ့ ဖော်ပြချက် ပါရင် denoise လုပ်တဲ့ network က အလုပ်လုပ်နေစဉ် အဲဒီ စာသားကို ကိုယ်စားပြုတဲ့ ဖော်ပြပုံ (representation) တစ်ခုကိုပါ လက်ခံနိုင်ပါတယ်။ ဒီ conditioning (စာသား စတဲ့ အပို အချက်အလက်နဲ့ ပုံထုတ်တာကို လမ်းညွှန်ခြင်း) က ပုံထုတ်တာကို အစက်အပြောက်ကနေ ကြုံရာ ပုံ တစ်ပုံဆီ မဟုတ်ဘဲ “a lighthouse at sunset” (နေဝင်ချိန်က မီးပြတိုက်) လို ဖော်ပြချက်နဲ့ ကိုက်ညီတဲ့ ပုံဆီ ဦးတည်စေပါတယ်။ နောက် အပိုင်းက စကားလုံးတွေက ပုံကို ဘယ်လို လမ်းညွှန်လဲ ရှင်းပြပါတယ်၊ အဲဒါက ဒီစာမျက်နှာရဲ့ သင်္ချာ ပိုပါတဲ့ အပိုင်းပါ။
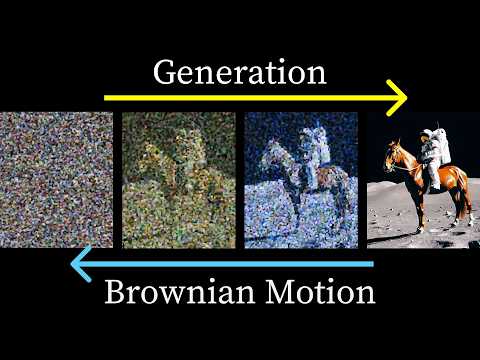
8:15 ကနေ diffusion ကို ပုံတွေနဲ့ ရှင်းပြထားပါတယ်။ Video အပြည့်က 37 မိနစ် ရှည်ပြီး သင်္ချာ အများကြီး ပါပါတယ်၊ သူ့ရဲ့ အစောပိုင်း အပိုင်းက embedding တွေနဲ့ စာသားက ပုံကို ဘယ်လို လမ်းညွှန်လဲ ဆိုတာကို ရှင်းပြပါတယ်၊ ဒါတွေက နောက် အပိုင်းက အယူအဆတွေပါ။ သူ ဖော်ပြတဲ့ tool တွေက 2022 လောက်က ဖြစ်လို့ အဲဒီ အချိန်က ဥပမာတွေအဖြစ် ယူပါ၊ သူ ရှင်းပြတဲ့ အလုပ်လုပ်ပုံကတော့ ဒီမှာ ဖော်ပြထားတဲ့ အတိုင်းပါပဲ။
Text Conditioning (စာသားနဲ့ လမ်းညွှန်ခြင်း): ဝါကျ တစ်ကြောင်းက ပုံကို ဘယ်လို လမ်းညွှန်လဲ
ထပ်ဆင့် လေ့လာရန်၊ ပြီးတော့ ဒီစာမျက်နှာရဲ့ အဆင့်မြင့် တစ်ဝက်ပါ: အယူအဆတွေက ဂျီဩမေတြီ ဆန်ပြီး အရင်းအမြစ်တွေက သင်္ချာ ဆန်ပါတယ်။ A4.2.3 ပေါ်မှာ အခြေခံပါတယ်၊ ဘာလို့လဲဆိုတော့ shared embedding space (ပုံနဲ့ စာ နှစ်မျိုးလုံးကို ဂဏန်း စာရင်းတွေအဖြစ် နေရာချထားတဲ့ မျှသုံး space) က သင်ယူထားတဲ့ ကျစ်လျစ်တဲ့ ဖော်ပြပုံ တစ်ခု ဖြစ်လို့ပါ။ A4.3.2 ပေါ်မှာလည်း အခြေခံပါတယ်၊ ဘာလို့လဲဆိုတော့ classifier တစ်ခုက ဘေးထွက် ရလဒ်အဖြစ် ပေါ်လာလို့ပါ။ ဒီအပိုင်းက တစ်ဆင့် ပိုလွန်နေတယ် ထင်ရင် နှိုင်းယှဉ်ချက် ကို ကျော်သွားပါ: စာမျက်နှာရဲ့ ကျန်တဲ့ အပိုင်းက ဒီအပိုင်းပေါ် မမူတည်ပါဘူး။
စာသားက ပုံထုတ်တာကို လမ်းညွှန်နိုင်ဖို့ ဆိုရင် အရင်ဆုံး စာသားနဲ့ ပုံကို နှိုင်းယှဉ်လို့ ရရပါမယ်။ အဲဒါကို CLIP (Contrastive Language-Image Pretraining၊ ပုံနဲ့ စာကို ယှဉ်ပြီး ကြိုတင် train လုပ်ထားတဲ့ model) က ပေးပါတယ်။ CLIP က အတူ train လုပ်ထားတဲ့ encoder နှစ်ခုပါ: တစ်ခုက ပုံကို vector (ဂဏန်း စာရင်း) အဖြစ် ပြောင်းပြီး နောက်တစ်ခုက caption (ပုံကို ဖော်ပြတဲ့ စာ) ကို vector အဖြစ် ပြောင်းပါတယ်။ Training က ကိုက်ညီတဲ့ ပုံနဲ့ caption အတွဲ တစ်တွဲစီကို နီးနီးကပ်ကပ် ဆွဲယူပြီး မကိုက်ညီတဲ့ အတွဲတွေကို ဝေးဝေး တွန်းထုတ်ပါတယ်။ အဲဒီ ဆွဲယူ၊ တွန်းထုတ် training ကို “contrastive” (ကိုက်တာနဲ့ မကိုက်တာကို ယှဉ်ပြီး သင်ယူတဲ့) လို့ ခေါ်တာပါ။ နီးစပ်မှုကို cosine similarity (vector နှစ်ခု ဦးတည်ချက် ဘယ်လောက် တူလဲ တိုင်းတဲ့ တန်ဖိုး) နဲ့ တိုင်းပါတယ်၊ vector နှစ်ခု ဦးတည်ချက် တူရင် တန်ဖိုး မြင့်ပါတယ်။
ရလဒ်က ပုံရော စကားလုံးရော ပါတဲ့ မျှသုံး space တစ်ခုပါ။ အဲဒါက language models စာမျက်နှာ က word space (စကားလုံးတွေကို နေရာချထားတဲ့ space) လိုပဲ အလုပ်လုပ်ပါတယ်: ဦးတည်ချက်တွေမှာ အဓိပ္ပာယ် ပါပါတယ်။ မူရင်း အရင်းအမြစ်က ဒါကို ဦးထုပ်နဲ့ ပြထားပါတယ်၊ ဒီစာမျက်နှာရဲ့ ဥပမာကတော့: နေကာမျက်မှန် တပ်ထားတဲ့ portrait (လူ့မျက်နှာ ပုံ) ရဲ့ vector ကနေ နေကာမျက်မှန် မတပ်ထားတဲ့ အဲဒီ portrait ရဲ့ vector ကို နုတ်လိုက်ရင် ရလာတဲ့ ကွာခြားချက်က “sunglasses” (နေကာမျက်မှန်) ဆိုတဲ့ စကားလုံးရဲ့ vector နားမှာ ကျပါတယ်။
ပုံတွေနဲ့ caption တွေ space တစ်ခုတည်းထဲမှာ။ မျှသုံး space က classifier တစ်ခုကိုလည်း ပေးပါတယ်: ပုံ တစ်ပုံကို label တပ်ဖို့ သူ့ရဲ့ embedding (ဒေတာကို ကိုယ်စားပြုတဲ့ ဂဏန်း vector) ကို ဖြစ်နိုင်တဲ့ caption တွေရဲ့ embedding တွေနဲ့ နှိုင်းယှဉ်ပြီး score အမြင့်ဆုံး ကိုက်ညီတာကို ရွေးပါ။ ဒါက pixel တွေပေါ်မှာ မဟုတ်ဘဲ အဓိပ္ပာယ်ပေါ်မှာ အလုပ်လုပ်တဲ့ nearest-match classification (A4.3.2၊ အနီးဆုံး ကိုက်ညီတာကို ရွေးပြီး အမျိုးအစား ခွဲခြင်း) ပါ။
ပုံထဲက စာတွေရဲ့ အဓိပ္ပာယ်: photo, sunglasses (နေကာမျက်မှန် တပ်ထားတဲ့ ဓာတ်ပုံ)၊ photo, plain (ရိုးရိုး ဓာတ်ပုံ)၊ one shared space (မျှသုံး space တစ်ခု)၊ match: close together (ကိုက်ညီ: နီးနီးကပ်ကပ်)၊ mismatch: far apart (မကိုက်ညီ: ဝေးဝေး)၊ the “sunglasses” direction (နေကာမျက်မှန် ဦးတည်ချက်)၊ “a portrait wearing sunglasses” (နေကာမျက်မှန် တပ်ထားတဲ့ portrait)၊ “a portrait” (portrait တစ်ပုံ)။
မျှသုံး space ရှိပြီဆိုရင် လမ်းညွှန်တဲ့ နည်းစနစ်က အယူအဆ သုံးခုကို ဆင့်ပြီး ပေါင်းထားတာပါ:
- Conditioning: caption ရဲ့ vector ကို denoise အဆင့် တိုင်းထဲ ထည့်ပေးပါ။ ဒါမှ noise ဖယ်တိုင်း ပုံကို ဖော်ပြချက်နဲ့ ကိုက်တဲ့ ပုံဆီ ရွေ့သွားစေပါတယ်။
- Classifier-free guidance (classifier မသုံးဘဲ ပုံကို prompt ဘက် ပိုလိုက်အောင် လမ်းညွှန်ခြင်း): အဆင့် တစ်ဆင့်စီကို နှစ်ခါ run ပါ၊ တစ်ခါ prompt နဲ့၊ တစ်ခါ prompt မပါဘဲ။ ဦးတည်ချက် နှစ်ခုကြား ကွာခြားချက်ကို ယူပြီး ပိုကြီးအောင် ချဲ့ပါ။ Guidance strength (prompt ကို ဘယ်လောက် အလေးထားမလဲ သတ်မှတ်တဲ့ setting) က ချဲ့တဲ့ ပမာဏကို ထိန်းပါတယ်: တင်လိုက်ရင် output က prompt ကို ပိုပြင်းပြင်း လိုက်ပါတယ် (အရမ်း တင်လွန်းရင်တော့ သဘာဝ နည်းလာပါတယ်)။
- Negative prompts (မလိုချင်တာကို ဖော်ပြတဲ့ prompt): အဲဒီ တွက်နည်းကိုပဲ ပြောင်းပြန် လုပ်တာပါ။ မလိုချင်တာကို ဖော်ပြပြီး အဲဒီ ဦးတည်ချက်ကို နုတ်ပါ။
သင်္ချာ အပြည့်အစုံ သိချင်ရင် အပေါ်က Welch Labs video (English) က CLIP ကို 3:37 ကစပြီး၊ cosine similarity ကို 5:36 ကစပြီး၊ မျှသုံး space နဲ့ သူ့ ဦးတည်ချက်တွေကို 6:24 ကစပြီး၊ conditioning ကို 26:41 ကစပြီး၊ guidance ကို 29:53 ကစပြီး နဲ့ negative prompts ကို 33:37 ကစပြီး ရှင်းပြထားပါတယ်။
စတုတ္ထ အမျိုးအစား၊ အကြမ်းဖျင်း: Flow-Based Models (ပြန်လှည့်လို့ရတဲ့ အဆင့်တွေနဲ့ ပုံထုတ်တဲ့ model)
ထပ်ဆင့် လေ့လာရန်။ ပြန်လှည့်လို့ရတဲ့ ပြောင်းလဲမှု (reversible transformation) တွေနဲ့ အချက်အလက် ဆုံးရှုံးတဲ့ compression ကို နှိုင်းယှဉ်တာကနေ A4.2.3 နဲ့ ဆက်စပ်ပါတယ်။
အပေါ်က နည်းလမ်း သုံးမျိုးလုံးက တစ်နေရာရာမှာ အချက်အလက် ဆုံးရှုံးတာကို လက်ခံကြပါတယ်။ GAN က ဘာကိုမှ ပြန်တည်ဆောက်တာ မရှိပါဘူး။ Autoencoder ရဲ့ decoder က မူရင်းကို အတိအကျ မရဘဲ မူရင်းနဲ့ နီးစပ်တာကိုပဲ ရပါတယ်။ Diffusion က noise ထည့်တိုင်း အချက်အလက်ကို တမင် ဖျက်ဆီးပါတယ်။
Flow-based model တွေက အဲဒီ ဆုံးရှုံးမှုကို ရှောင်ပါတယ်။ သူတို့က noise ကနေ ပုံဆီ သွားတဲ့ လမ်းကြောင်းကို invertible transformation (တစ်ခုချင်းစီကို အတိအကျ ပြန်ဖျက်လို့ရတဲ့ အဆင့်) တွေနဲ့ တည်ဆောက်တာမို့ ကွင်းဆက်က ဦးတည်ချက် နှစ်ဖက်လုံး run နိုင်ပါတယ်: noise ကို ရှေ့ဆက် ဖြတ်လိုက်ရင် ပုံ ဖြစ်လာပြီး ပုံကို နောက်ပြန် ဖြတ်လိုက်ရင် သူ စခဲ့တဲ့ noise ကို ပြန်ရပါတယ်။ အကျိုးကျေးဇူးက သင့်တော်တဲ့ transformation တွေ သုံးရင် model က ပေးထားတဲ့ ပုံ တစ်ပုံရဲ့ likelihood (ဒေတာအကြောင်း သင်ယူထားတာအရ အဲဒီ ပုံ ဘယ်လောက် ဖြစ်နိုင်ချေ ရှိလဲ) ကို တွက်နိုင်တာပါ။ ပေးရတဲ့ အဖိုးကတော့ ဒီဇိုင်း လွတ်လပ်မှုပါ: အဆင့်တိုင်း invertible ဖြစ်ရမှာမို့ network သုံးနိုင်တဲ့ operation (ဒေတာပေါ်မှာ လုပ်တဲ့ လုပ်ဆောင်ချက်) တွေကို ကန့်သတ်ပါတယ်။ အတိုချုပ် ပြောရရင် ပြန်လှည့်နိုင်မှု (reversibility) က အဓိက အယူအဆဖြစ်ပြီး ဒီဇိုင်း လွတ်လပ်မှုကို လျှော့ပြီး likelihood အတိအကျကို ရယူတာက trade-off (တစ်ခု ရဖို့ တစ်ခု အလျှော့ပေးရတာ) ပါ။
နည်းလမ်းတွေကို ဘယ်လို ပေါင်းသုံးလဲ
ထပ်ဆင့် လေ့လာရန်။ ပုံဖန်တီးတဲ့ စနစ်တွေက နည်းလမ်းတွေကို ပေါင်းသုံးနိုင်ပါတယ်၊ ဥပမာ autoencoder ရဲ့ latent space ထဲမှာ diffusion ကို သုံးတာမျိုးပါ။
အပေါ်မှာ ဖော်ပြခဲ့တဲ့ diffusion က တွက်ချက်ရ ကုန်ကျစရိတ် များပါတယ်: denoise အဆင့် တိုင်းက အရွယ်အစား အပြည့်ရှိတဲ့ ပုံရဲ့ pixel တိုင်းကို တွက်ချက်ရပြီး ပုံထုတ်တာမှာ အဆင့် အများကြီး လိုပါတယ်။ Autoencoder က ပုံ တစ်ပုံကို အရေးကြီးတဲ့ အချက်အလက်တွေ မပျောက်အောင် အများကြီး ပိုသေးတဲ့ code အဖြစ် ချုံ့ပါတယ်။ Latent diffusion (latent space ထဲမှာ လုပ်တဲ့ diffusion) က နှစ်ခုကို ပေါင်းပါတယ်: denoise loop ကို မူရင်း pixel တွေပေါ်မှာ မဟုတ်ဘဲ အဲဒီ code သေးသေးလေးပေါ်မှာ run ပြီး နောက်ဆုံးမှာ တစ်ကြိမ်တည်း ပုံ အပြည့် အဖြစ် decode လုပ်ပါတယ်။ အခု ကုန်ကျစရိတ် များတဲ့ အပိုင်းက အများကြီး ပိုသေးတဲ့ အရာပေါ်မှာ ဖြစ်သွားပါပြီ။ Text-to-image (စာကနေ ပုံ ထုတ်တဲ့) စနစ် အများအပြားက ဒီ ဒီဇိုင်းကို သုံးကြပါတယ် (2026 ခုနှစ် အခြေအနေ)။ အဲဒီ စနစ်တွေမှာ အပေါ်က ဖော်ပြခဲ့တဲ့ CLIP အုပ်စုထဲက တစ်ခုလို text encoder (စာကို vector အဖြစ် ပြောင်းတဲ့ encoder) က prompt ကို ပေးပါတယ်။ ဒီ hybrid (ရောစပ်) စနစ်တွေထဲမှာ adversarial training လည်း ပါပါတယ်: autoencoder ရဲ့ decoder မှာ တွဲထားတဲ့ discriminator က output ကို မူရင်းနဲ့ နီးရုံသာ မကဘဲ အစစ်လို ထင်ရအောင် တွန်းအားပေးပါတယ်၊ ဒါက အသေးစိတ်တွေကို ပိုကောင်းစေပါတယ်။
ဒီ နည်းလမ်းတွေကို စနစ် တစ်ခုတည်းမှာ ပေါင်းသုံးနိုင်ပါတယ်။ တစ်ခုစီ ဘာကို ကောင်းကောင်း လုပ်နိုင်လဲ၊ လုပ်ငန်းစဉ်ရဲ့ ဘယ်နေရာမှာ အထောက်အကူ ဖြစ်နိုင်လဲ နှိုင်းယှဉ်ကြည့်ပါ။ စာမေးပွဲမှာ မေးတဲ့ အသုံးချပုံ တစ်ခုအတွက် Case Study အပိုင်းထဲက Hybrid Models စာမျက်နှာ ကို ကြည့်ပါ။
နည်းလမ်း သုံးမျိုးကို နှိုင်းယှဉ်ခြင်း
ထပ်ဆင့် လေ့လာရန်၊ A4.3.10 (HL) နဲ့ ဆက်စပ်ပါတယ်: အလုပ် တစ်ခုအတွက် နည်းလမ်းတွေကို နှိုင်းယှဉ်ဖို့ ဇယားကို ဖြည့်ပါ။ ထပ်ဆောင်း လုပ်ချင်ရင် flow-based model တွေအတွက် အတန်း တစ်တန်း ထည့်ပါ။
ဒီဇယားကို ကူးပြီး အပေါ်က ရှင်းလင်းချက်တွေကို သုံးပြီး ဖြည့်ပါ။ ဒီမှာ မဖော်ပြထားတဲ့ ကန့်သတ်ချက်တွေအတွက် ချိတ်ထားတဲ့ case study စာမျက်နှာတွေကို ကြည့်ပါ။
| ဘယ် score ကို တိုးတက်အောင် လုပ်နေလဲ။ | Network ဘယ်နှစ်ခုလဲ။ | Network ကို တစ်ခေါက်ပဲ ဖြတ်လား၊ အများကြီးလား။ | ချို့ယွင်းရင် ဘယ်လို ပုံစံ ပေါ်လဲ။ | |
|---|---|---|---|---|
| GAN | ||||
| VAE | ||||
| Diffusion |
ကိုယ့်အဖြေတွေနဲ့ နှိုင်းယှဉ်ရန်
- GAN: score = generator က discriminator ကို ဘယ်လောက် မကြာခဏ လှည့်စားနိုင်လဲ (network နှစ်ခုရဲ့ ရည်မှန်းချက်တွေက ဆန့်ကျင်ဘက်ပါ)။ Network နှစ်ခု။ Generator ကို တစ်ခေါက် ဖြတ်ရုံနဲ့ ပုံ တစ်ပုံ ရပါတယ်။ ချို့ယွင်းချက်: mode collapse (output တွေ ဆင်တူနေတာ) နဲ့ converge မဖြစ်တဲ့ training။
- VAE: score = decoder ပြန်တည်ဆောက်တာက မူရင်းနဲ့ ဘယ်လောက် နီးစပ်လဲ၊ အဲဒါအပြင် code တွေကို latent space ထဲမှာ ညီညီညာညာ ပြန့်နေအောင် ထိန်းတာ (regularisation၊ သင်ယူတာကို ကန့်သတ်ချက် တစ်ခုနဲ့ ထိန်းခြင်း)။ Network တစ်ခုကို နှစ်ပိုင်း ခွဲထားတာပါ၊ encoder နဲ့ decoder။ Decoder ကို တစ်ခေါက် ဖြတ်ရုံနဲ့ ပုံ တစ်ပုံ ထုတ်ပါတယ်။ ချို့ယွင်းချက်: ဒီစာမျက်နှာမှာ မဖော်ပြထားပါ။
- Diffusion: score = network က noise ပါတဲ့ ပုံကနေ noise ကို ဘယ်လောက် ကောင်းကောင်း ဖယ်နိုင်လဲ။ Network တစ်ခု၊ အကြိမ်ကြိမ် သုံးတာမို့ ပုံထုတ်ဖို့ network ကို အကြိမ်များစွာ ဖြတ်ရပါတယ်။ ချို့ယွင်းချက်: ဒီစာမျက်နှာမှာ မဖော်ပြထားပါ။
ဒီစာမျက်နှာက ချို့ယွင်းချက် အားလုံးကို မဖော်ပြထားတာမို့ အကွက် တချို့ ဗလာ ကျန်နိုင်ပါတယ်။ ကန့်သတ်ချက်တွေနဲ့ အကဲဖြတ်ခြင်း အကြောင်း ပိုသိချင်ရင် Evaluating Models (model တွေကို အကဲဖြတ်ခြင်း) ကို ကြည့်ပါ။
Video ကော ဘယ်လိုလဲ
ထပ်ဆင့် လေ့လာရန်။ A4.4.1 နဲ့ ဆက်စပ်ပါတယ်: လှုပ်ရှားနေတဲ့ ပုံတွေမှာလည်း ငြိမ်နေတဲ့ ပုံတွေလိုပဲ ဘယ်သူ ဖန်တီးတာလဲ (authorship) နဲ့ ခွင့်ပြုချက် (consent) မေးခွန်းတွေ ပေါ်လာပြီး အကျိုးဆက် ပိုကြီးပါတယ်။ Welch Labs video က noise သက်သက်က လှုပ်ရှားနေတဲ့ မြင်ကွင်း ဖြစ်လာတာ (0:47 ကစပြီး) ကို ပြထားပါတယ်။ အခြေခံ အယူအဆကို သိပြီးသားပါ: diffusion ပါပဲ၊ ဒါပေမဲ့ temporal consistency (အချိန်အလိုက် ကိုက်ညီမှု) ဆိုတဲ့ အပို လိုအပ်ချက် ပါပါတယ်: frame (video ထဲက ပုံ တစ်ပုံ) တစ်ခုကနေ နောက် frame တစ်ခုအထိ အရာဝတ္ထုတွေနဲ့ လှုပ်ရှားမှုတွေ ကိုက်ညီ ဆက်စပ်နေရပါမယ်။ အဲဒီ ကိုက်ညီမှုကို ဘယ်လို ရအောင် လုပ်လဲ ဆိုတာကတော့ ဒီစာမျက်နှာရဲ့ နယ်ပယ်ကို ကျော်လွန်ပါတယ်။ (ဒီအချက်က 2026 ခုနှစ်က အခြေအနေပါ။)
Ethics (ကျင့်ဝတ်): ဒီပုံကို ဘယ်သူ ဖန်တီးတာလဲ
သင်ရိုးထဲမှာ ပါပါတယ်: A4.4.1 နဲ့ A4.4.2 က ဒီလို မေးခွန်းတွေကို Discuss (အမြင် အမျိုးမျိုးကို စဉ်းစားပြီး ကောက်ချက် တစ်ခုကို အထောက်အထားနဲ့ ပြပါ) ဆိုတဲ့ command term (မေးခွန်းက ဘာလုပ်ခိုင်းလဲ ပြတဲ့ IB ရဲ့ သတ်မှတ် စကားလုံး) နဲ့ လေ့လာစေပါတယ်။ ဒါကြောင့် သင်္ချာ ပါတဲ့ အပိုင်းတွေကို ကျော်ခဲ့ရင်တောင် ဒီအပိုင်းကို ဖတ်ပါ။
Training data နဲ့ ဖန်တီးထားတဲ့ ပုံတွေအကြောင်း ဒီမေးခွန်းတွေကို စဉ်းစားကြည့်ပါ:
- Training data နဲ့ ခွင့်ပြုချက်။ ပုံ model တွေကို web ပေါ်ကနေ စုဆောင်းထားတဲ့ ဓာတ်ပုံတွေ၊ အနုပညာ လက်ရာတွေနဲ့ train လုပ်လေ့ ရှိပါတယ်၊ အဲဒီထဲမှာ ခွင့်မတောင်းခဲ့တဲ့ အသက်ရှင်ဆဲ အနုပညာရှင်တွေရဲ့ လက်ရာတွေလည်း ပါပါတယ်။ ဖန်တီးသူတွေက ဒီလို သုံးတာကို ခွင့်ပြုခဲ့ကြလား၊ သူတို့ကို ဘယ်လို အသိအမှတ်ပြုသင့်လဲ ဒါမှမဟုတ် လျော်ကြေး ပေးသင့်လဲ။ Model က သိမ်းထားတဲ့ ပုံတွေကို ပြန်ထုတ်တာထက် ပုံ အသစ်တွေကို ဖန်တီးလေ့ ရှိပေမဲ့ သူ့ရဲ့ စွမ်းရည်တွေကို အဲဒီ လက်ရာတွေကနေ သင်ယူခဲ့တာပါ: ဒါက အနုပညာရှင် တစ်ယောက်က တခြားသူတွေဆီက သင်ယူတာနဲ့ တူသလား၊ ဒါမှမဟုတ် စက်ရုံ အတိုင်းအတာနဲ့ ကူးယူတာလား။ Model တွေက training ပုံ တချို့ကို အလွတ်မှတ်မိပြီး ပြန်ထုတ်နိုင်တာမို့ copyright (မူပိုင်ခွင့်) နဲ့ privacy (ကိုယ်ရေးလုံခြုံမှု) ဆိုင်ရာ စိုးရိမ်ချက်တွေ ပေါ်လာပါတယ်၊ diffusion model တွေရဲ့ memorisation (training ဒေတာကို အလွတ်မှတ်မိခြင်း) အကြောင်း သုတေသန ကို ကြည့်ပါ။ စာရေးဆရာတွေရဲ့ လက်ရာတွေနဲ့ train လုပ်ထားတဲ့ language model (စာသားကို နားလည်ပြီး ထုတ်ပေးတဲ့ model) တွေမှာလည်း ဒီမေးခွန်းတွေ အတူတူ သက်ဆိုင်ပါတယ်။
- အစစ်လို ထင်ရတာနဲ့ အစစ် ဖြစ်တာ မတူပါဘူး။ Generator က တကယ် မဖြစ်ခဲ့တဲ့ ဖြစ်ရပ်တွေရဲ့ ဓာတ်ပုံတွေလို ထင်ရတဲ့ ပုံတွေကို ထုတ်ပါတယ်။ တရားရုံးတွေ၊ သတင်းလောကနဲ့ ကိုယ့်ရဲ့ group chat တွေမှာ အထောက်အထား အနေနဲ့ “မျက်စိနဲ့ မြင်ရရင် ယုံရတယ်” ဆိုတဲ့ အယူအဆ ဘာဖြစ်သွားမလဲ။
- ဘယ်သူက ဖန်တီးသူလဲ။ Prompt ကို သင် ရေးခဲ့တယ်၊ ကုမ္ပဏီက model ကို train လုပ်ခဲ့တယ်၊ ဓာတ်ပုံဆရာ 10 သန်းက training data ကို ပေးခဲ့တယ် ဆိုရင် ဒီပုံက ဘယ်သူ့ ပုံလဲ၊ အဲဒီပုံက ထိခိုက်မှု ဖြစ်စေရင် ဘယ်သူ တာဝန်ယူရမလဲ။
Welch Labs video က training data နဲ့ ဖန်တီးသူ ဘယ်သူလဲ ဆိုတဲ့ ကိစ္စကို 34:26 ကစပြီး ဆွေးနွေးထားပါတယ်။ တာဝန်ယူမှု၊ ခွင့်ပြုချက်နဲ့ bias (ဘက်လိုက်မှု) အကြောင်းအတွက် Ethics of Machine Learning (machine learning ရဲ့ ကျင့်ဝတ်ဆိုင်ရာ ကိစ္စများ) ကို ဆက်ဖတ်ပါ။
ဒီစာမျက်နှာမှာ မပါတဲ့ အကြောင်းအရာများ
ဒီစာမျက်နှာက အောက်ပါ ခေါင်းစဉ်တွေကို မဖော်ပြထားပါဘူး:
- အသစ် ဖန်တီးတာ မဟုတ်ဘဲ ပြင်ဆင်တာ: ပုံရဲ့ အပိုင်း တစ်ခုကို ဖြည့်တာ၊ ပုံကို ချဲ့ထွင်တာ၊ upscaling (ပုံကို pixel ပိုများအောင် ချဲ့ခြင်း)၊ style transfer (ပုံ တစ်ပုံရဲ့ ဟန်ကို နောက်ပုံ တစ်ပုံဆီ ကူးပြောင်းခြင်း)။
- ဖန်တီးထားတဲ့ ပုံတွေကို အကဲဖြတ်ခြင်း: Case Study အပိုင်းထဲက Evaluating Models ကို ကြည့်ပါ။
ဆက်စပ်တဲ့ စာမျက်နှာများ
- သင်ရိုးထဲမှာ: What Machine Learning Is (machine learning ဆိုတာ ဘာလဲ): A4.1.1 က machine learning အမျိုးအစားတွေနဲ့ သူတို့ရဲ့ အသုံးချပုံတွေကို ဖော်ပြပြီး A4.1.2 က ဒါတွေ အားလုံး ဘာလို့ parallel hardware (အလုပ် အများကြီးကို တစ်ပြိုင်နက် လုပ်နိုင်တဲ့ hardware) ပေါ်မှာ run လဲ ရှင်းပြပါတယ်။
- သင်ရိုးထဲမှာ (HL): neural network တွေ အကြောင်း ယေဘုယျ သိဖို့ What Machine Learning Is (A4.3.8)၊ dimensionality reduction (A4.2.3၊ autoencoder လုပ်တဲ့ အလုပ်) နဲ့ CNNs (A4.3.9၊ ပုံတွေကို ဖန်တီးတာ မဟုတ်ဘဲ ဖတ်တဲ့ network) အတွက် Training and Evaluating a Model၊ classification (A4.3.2၊ discriminator ရဲ့ အလုပ်ဖြစ်ပြီး CLIP မျှသုံး space ရဲ့ အသုံးချပုံ တစ်ခုလည်း ဖြစ်ပါတယ်) အတွက် Types of Learning။
- သင်ရိုးထဲမှာ: ethics အပိုင်းက မေးခွန်းတွေအတွက် Ethics of Machine Learning (A4.4.1) နဲ့ Computing in Daily Life (A4.4.2)။
- ထပ်ဆင့် လေ့လာရန်: How Large Language Models Work က အဓိပ္ပာယ်ကို space တစ်ခုထဲက နေရာအဖြစ် ဖော်ပြတဲ့ embedding အယူအဆ အတူတူကို သုံးပါတယ်။ AI Beyond Machine Learning က training မဟုတ်ဘဲ စည်းမျဉ်းတွေနဲ့ ရှာဖွေခြင်း (search) ကနေ အလုပ်လုပ်တဲ့ AI နည်းလမ်းတွေကို ဖော်ပြပါတယ်။
- စာမေးပွဲမှာ မေးတဲ့ အပိုင်း (Paper 1 Section B၊ 2027 cohort): Case Study အပိုင်း က ပုံဖန်တီးတဲ့ နည်းစနစ်တွေ၊ GANs၊ diffusion၊ hybrid model တွေ၊ အကဲဖြတ်ခြင်း၊ ethics နဲ့ ဥပဒေ ကိစ္စတွေကို စာမေးပွဲမှာ မေးမယ့် အကြောင်းအရာအဖြစ် ဖော်ပြပါတယ်။ ဒီစာမျက်နှာက အဲဒီ နောက်ကွယ်က အယူအဆဆိုင်ရာ နောက်ခံ ဖြစ်ပါတယ်။ (Paper 1 Section B က IB Computer Science စာမေးပွဲရဲ့ ပထမ စာစောင်ထဲက case study မေးခွန်းတွေ ပါတဲ့ အပိုင်းဖြစ်ပြီး 2027 cohort ဆိုတာ 2027 ခုနှစ်မှာ စာမေးပွဲ ဖြေမယ့် ကျောင်းသား အသုတ်ကို ဆိုလိုပါတယ်။)
ဒီစာမျက်နှာရဲ့ အရင်းအမြစ်များနဲ့ ရက်စွဲများ
2026 ဇူလိုင်မှာ ရေးထားပြီး ကိုးကားထားတာတွေက: Welch Labs ရဲ့ “But how do AI images and videos actually work?” (အပေါ်မှာ ထည့်ထားပါတယ်၊ သူ့ ဥပမာတွေက 2022 ဝန်းကျင်ကပါ)၊ CS50 ရဲ့ “Fundamentals of AI” ထဲက computer vision (ကွန်ပျူတာက ပုံတွေကို နားလည်အောင် လုပ်ခြင်း) နဲ့ Generating (2026) သင်ခန်းစာတွေ (အချိန်ရှည်တဲ့ တိုက်ရိုက် ရိုက်ကူးချက်တွေ ဖြစ်လို့ စာမျက်နှာထဲ မထည့်ဘဲ link ပဲ ပေးထားပါတယ်) နဲ့ Carlini et al., Extracting Training Data from Diffusion Models တို့ပါ။ ဒီစာမျက်နှာက ဥပမာတွေနဲ့ ပုံတွေ အားလုံးကို ကိုယ်တိုင် ဖန်တီးထားတာပါ၊ compression လေ့ကျင့်ခန်းက ဘယ် အရင်းအမြစ်နဲ့မှ မတူတဲ့ ဂဏန်းတွေနဲ့ ပုံစံကို သုံးထားပါတယ်။ ချိတ်ထားတဲ့ 2027 case study စာမျက်နှာတွေက GAN training ပြဿနာတွေ၊ hybrid model တွေနဲ့ အကဲဖြတ်ခြင်းကို ပိုအသေးစိတ် ဖော်ပြထားပါတယ်။